(中央社記者趙敏雅台北15日電)台灣主權AI訓練語料庫自去年底上線,已累計約5000筆資料集、超過22億詞元(tokens)。數發部長林宜敬今天宣布啟動民間語料徵集,現階段以具豐富語料資源的出版業及電子書平台為合作對象,號召更多民間創作力量加入,打造具台灣特色的可信賴AI。
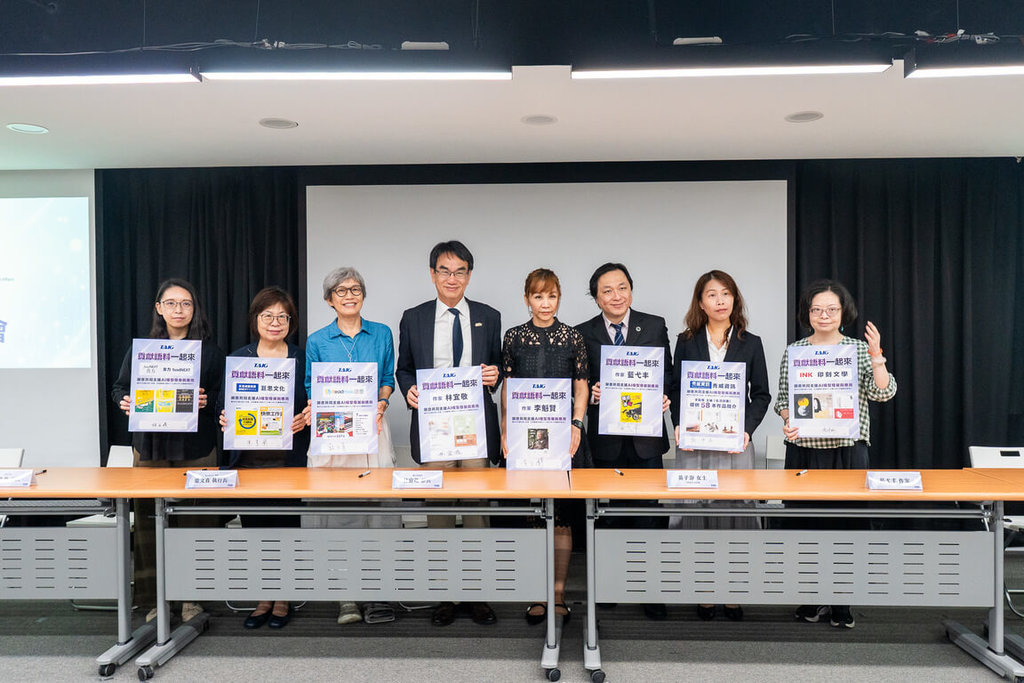
數發部今天舉行「台灣主權AI訓練語料庫啟動民間語料徵集」記者會,林宜敬率先以作家身分響應,另外,秀威資訊、印刻文學、Readmoo讀墨、食力、巨思文化等出版及電子書平台業者,以及作家藍弋丰等人出席簽署授權同意書。
林宜敬表示,AI模型對民主、權力等概念的理解,會受到訓練語料蘊含的社會與文化脈絡影響,目前國際大型語言模型的中文訓練資料,仍多以簡體中文內容為主,要讓AI更理解台灣,就必須讓台灣的語言、文化與價值,成為AI學習的一部分。
林宜敬指出,每當新科技對著作財產權帶來衝擊時,社會通常需數年才會形成共識,目前各國都有不同做法,隨著AI技術快速發展,「我們不能等」,否則國際大語言模型,甚至台灣自己的大型語言模型,提供的回答可能都沒有台灣觀點。
林宜敬表示,數發部成立台灣主權AI訓練語料庫,廣納高品質、具在地化的正體中文語料,已將政府擁有著作權的資料逐步放入,提供台灣、美國、日本等AI開發團隊使用,「如果有中國團隊想使用,也相當歡迎」。
林宜敬說明,民間語料徵集採自願參與,並非強制要求創作者提供作品,若未來作家想法改變,也能終止授權。他強調,授權資料僅限用於AI訓練,此外,目前國際間認為重要原則之一就是不能原文照抄,必須經過轉製(transformation),才算是合理使用。
數發部資料創新司司長王復中表示,台灣主權AI訓練語料庫自去年12月推動至今,採取「先政府再民間,先中央再地方」策略,由於政府資料已累積至一定規模,數發部將語料來源擴大至民間。
王復中指出,現階段以具豐富語料資源的出版業及電子書平台為合作對象,採無償授權方式推動;作者如有意願提供個人著作,可由出版社協助上架至語料庫。重點徵集內容包含經同意授權的出版品、出版品簡介、出版品試閱內容、已逾著作權保護期間並可作為公共財活化運用的典籍與創作。
至於數發部是否會審核民間內容,王復中回應,民間徵集主要由出版社負責篩選及把關品質,平台僅檢核內容結構、資料格式,以及資料是否適合供AI訓練等,不會干預內容。
數發部表示,邀請作者、出版社、文化機構、法人單位及各領域內容提供者共同參與,讓更多台灣原生內容成為支持台灣主權AI模型發展的重要養分,使AI模型更加理解台灣的語言、文化、歷史與社會脈絡。(編輯:張均懋)1150915